こんにちは、ネットワールド NetApp担当SEの藤岡です。
AI基盤を整えよう!という声が増えてきた昨今、「ビッグデータ」「データレイク」「S3」「スケーラブル」などのキーワードからオブジェクトストレージの導入を、とお考えの方も多いかと思います。
本記事ではNetAppのオブジェクトストレージであるStorageGRIDをテーマに、
- NetAppのオブジェクトストレージ「StorageGRID」って何者? 👈【本記事】
- VMware版StorageGRIDを作って使ってみよう!
- ONTAPとの連携:SnapMirror Cloudでバックアップを取ってみた
の3本立てでお送りいたします!
オブジェクトストレージの導入をお考えの方にStorageGRIDの魅力をお届けできれば幸いです。
- オブジェクトストレージとは
- StorageGRIDとは
- StorageGRIDの導入パターン
- StorageGRIDのアーキテクチャ
- StorageGRIDのここがすごい!ILMでデータ保管を最適化
- 次回予告
オブジェクトストレージとは
オブジェクトストレージとは、画像、動画、ログなどの非構造化データを、バケットと呼ばれる論理空間に「オブジェクト」単位で管理するストレージ方式です。
馴染みのあるファイルストレージとの違いはこんな感じです。
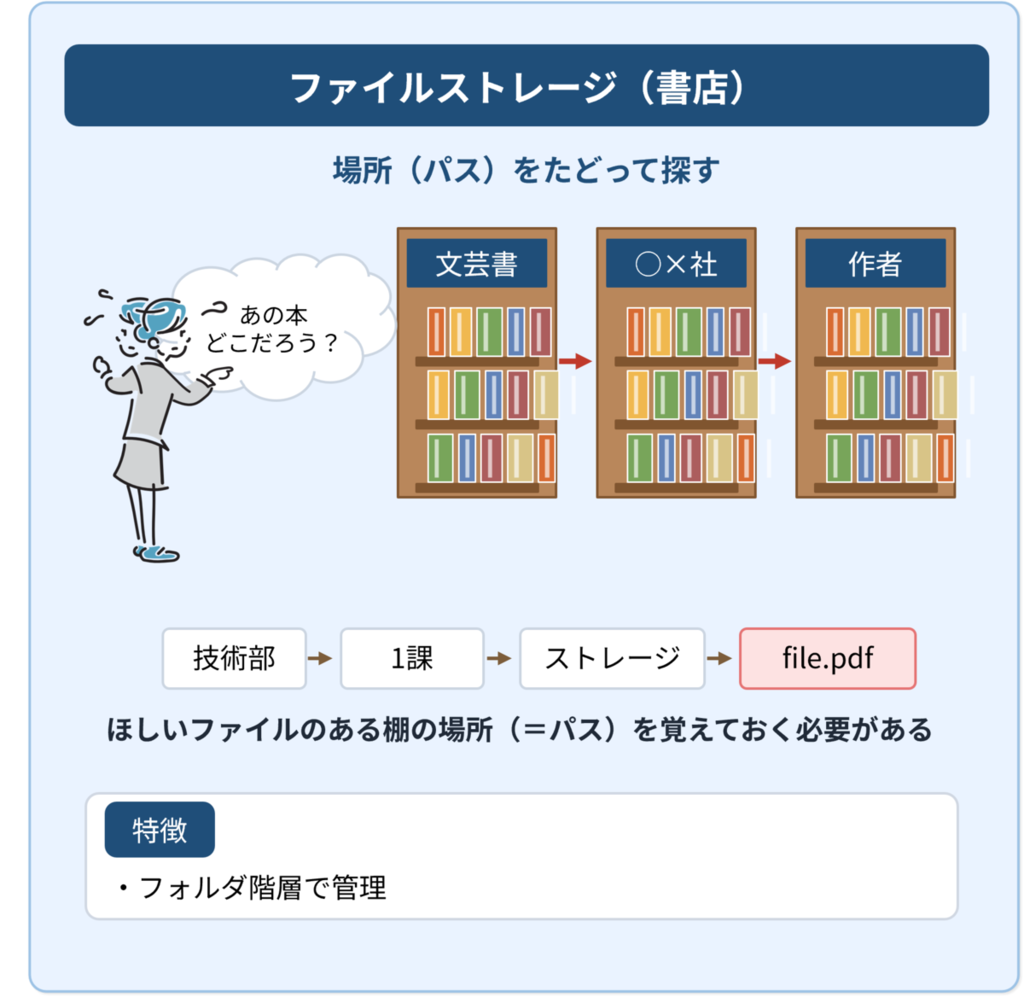
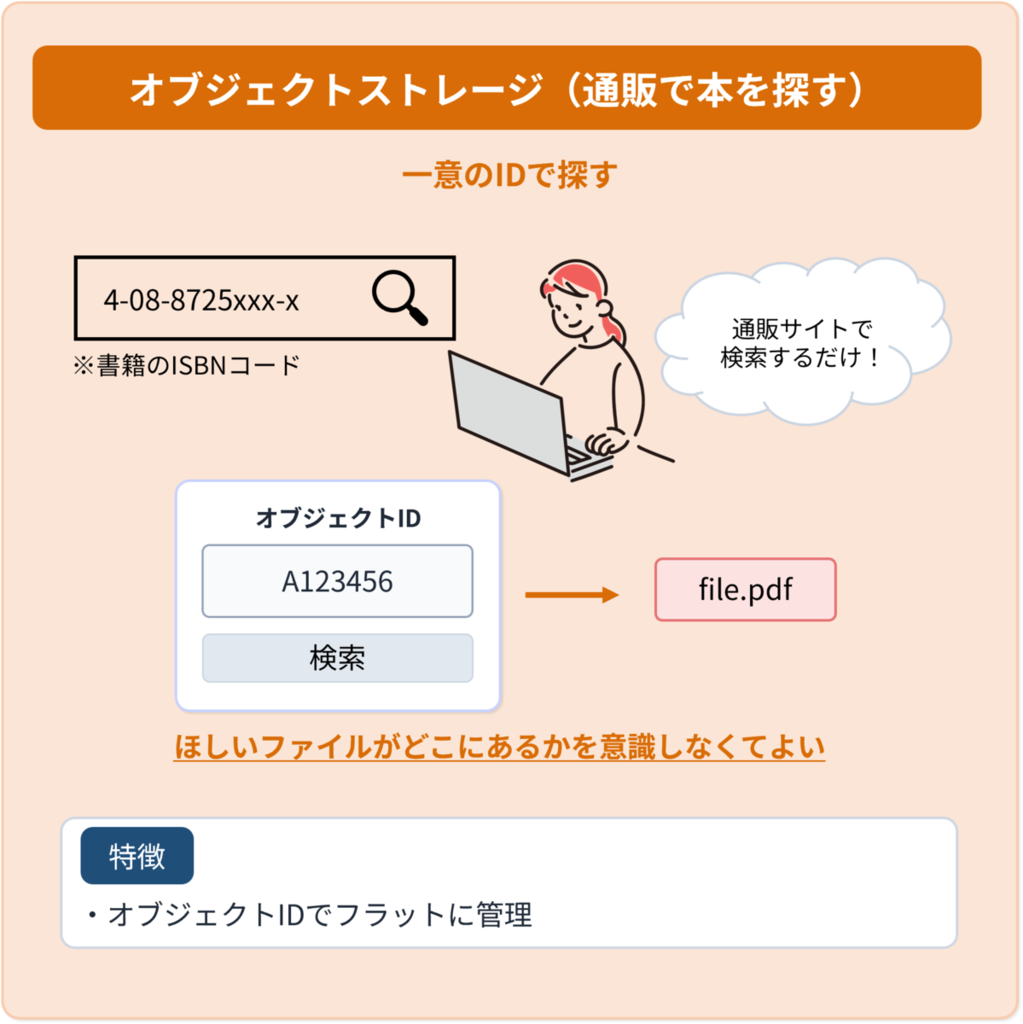
イメージつきましたでしょうか?
普段の業務で使う程度であればファイルの保存場所を覚えておけるかもしれませんが、扱うデータが超大量となるとそうもいきませんよね。
オブジェクトストレージが大量の非構造化データ管理に適している理由がお分かりいただけたかと思います。
また、オブジェクトストレージはデータを「データ本体」と「データについてのデータ=メタデータ」に分けて保存します。
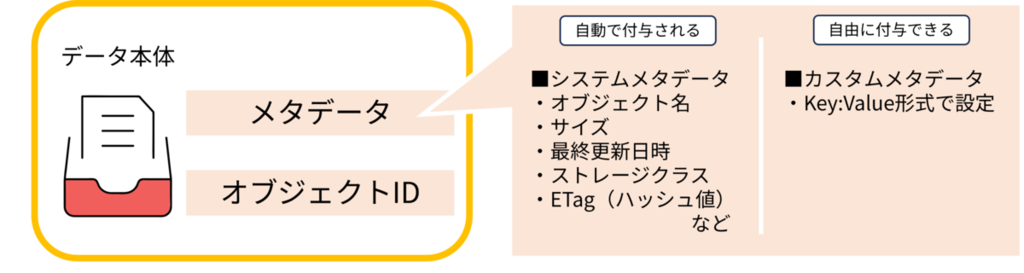
アップロード時刻やサイズのほか、自由につけることができるカスタムメタデータもメタデータに含まれるので、これを利用した検索や自在なデータライフサイクルの調整が可能です。
StorageGRIDとは
NetAppが提供するオブジェクトストレージであるStorageGRIDは、AWS S3 API互換のストレージです。多くのS3対応アプリケーションやバックアップソフトウェアからAWS S3と同様のインターフェースで利用できます。
AI学習データの保管、バックアップターゲット、データレイク、長期アーカイブなど、大容量の非構造化データを管理するための基盤として利用されています。
マルチサイト構成が得意なストレージでもあるので、例えば東京と大阪に分けて導入して災害対策をしつつ、利用者にはひとつのS3ストレージとして提供できます。
S3プロトコルを使うならNetAppのONTAP S3機能でもよいのでは?と思われるかもしれません。
もちろんONTAP S3も選択肢のひとつですが、オブジェクトストレージを主用途とし、ペタバイト級の容量やマルチサイト構成を求める場合にはStorageGRIDが適しています。
一方で、すでにNFSやSMBによるNAS環境を利用しており、一部のアプリケーション向けにS3アクセスも提供したい場合にはONTAP S3が有効です。既存のストレージ基盤を活用しながらS3機能を追加できるため、ONTAP運用のノウハウを活かしやすいというメリットがあります。
StorageGRIDの導入パターン
StorageGRIDの導入プラットフォームは以下の3つです。
- アプライアンス
- VMwareベースの仮想版
- ベアメタル形式での仮想版
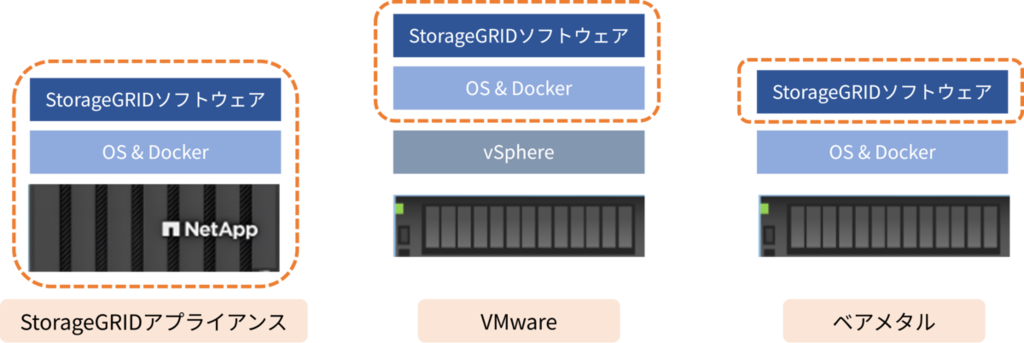
オレンジの点線で囲まれている部分がそれぞれのプラットフォームで提供される範囲を示しています。
本番環境では性能も容量もばっちりなアプライアンスでの導入をおすすめされることが多いですが、お手持ちのVM環境やサーバ上にパッケージを展開する方法もありますので、気軽に検証環境を構築することもできますよ。
また、すべてのプラットフォームにおいてコンテナという形でソフトウェアを展開していますので、あまり性能の要らない管理専用のマシンは仮想版で、性能が必要なストレージ部分はアプライアンスで、というように混在させる構成も可能です。
次回ブログにてVMware版StorageGRIDを構築する手順をご紹介しますので、こちらもぜひご覧ください!
StorageGRIDのアーキテクチャ
StorageGRIDはストレージシステムの役割をNode単位で分散させることで、負荷分散や性能向上を実現しています。
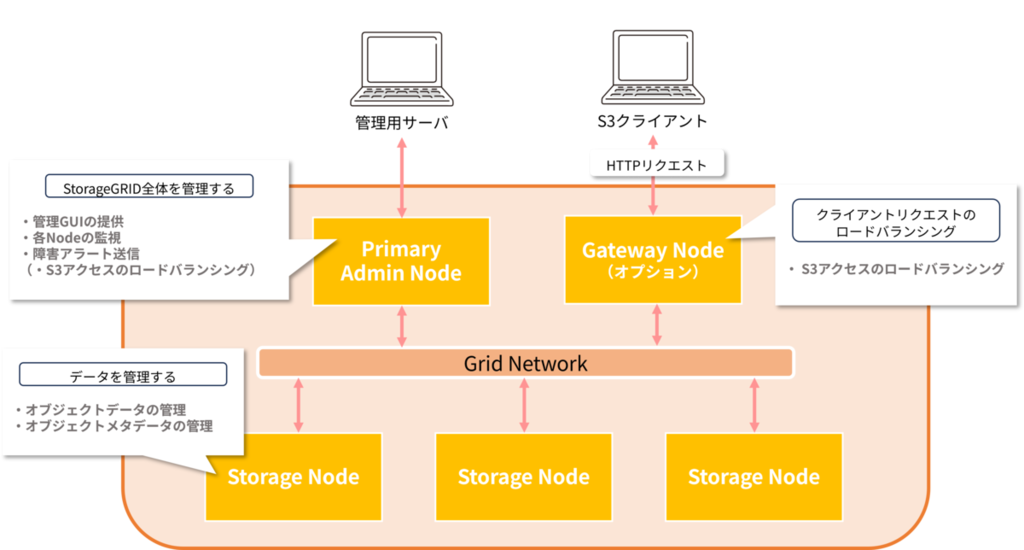
※こちらの構成はあくまで一例です。
StorageGRIDを構成するNodeは3種類です。
- Admin Node:StorageGRID全体を管理する
システム全体の構成、監視、ログ管理を担うNodeです。システムには必ず1台のPrimary Admin Nodeが存在し、必要に応じて追加のAdmin Nodeを配置して冗長化できます。
また、ロードバランサ機能を持つため、小規模環境であればデータアクセスの窓口として使うケースもあります。 - Storage Node:データを管理する
オブジェクトデータ本体と、オブジェクトメタデータを保管します。
複数のStorage Nodeで手分けしてオブジェクトデータを分散させることで、高い可用性と拡張性を実現します。また、Storage Nodeを追加することで容量だけでなく処理性能も向上させることができます。 - Gateway Node(オプション):クライアントリクエストのロードバランシング
全体の管理に使うAdmin Nodeとエンドポイント機能とを切り離して使いたい場合や、大規模環境で大量のクライアントリクエストが発生する場合には、エンドポイント専用となるGateway Nodeを導入することができます。
複数のGateway Nodeを導入すればHA構成をとることもできますので、エンドポイント障害に備える機能も持っています。
それぞれのNodeは1台から追加していくことができますので、容量の追加や性能向上といった要望に合わせて柔軟に対応していけるのが特徴です。
また、今回の例ではGrid Networkというネットワークの1つだけで内部通信、管理用サーバとの通信、S3クライアントとの通信を担う構成になっていますが、最大で3つのネットワークを付けることができますので、ワークロードを分けたい環境にも対応することができます。
StorageGRIDのここがすごい!ILMでデータ保管を最適化
StorageGRIDを語る上で外せないのがILM(Information Lifecycle Management、情報ライフサイクル管理)です。
ILMではオブジェクトデータを取り込んだ後どこに、どのように、いつまで保管しておくかをポリシーベースで定義でき、設定すればStorageGRIDが自動的に制御してくれますので、管理者がデータを手動で整理する手間が要りません。
StorageGRIDのILMでできることは多岐に渡るため、本記事ではものすごくざっくり、入り口の部分をご紹介していこうと思います。
- どこに?
StorageGRIDは「Pool」と呼ばれる論理容量を対象にデータを格納していきます。
3台のStorage Nodeがある環境ならば、3台分のDiskをすべてまとめたStorage Poolを作ることで、3台にまんべんなくデータを格納していくことができます。
また、外部のクラウドリソース(Amazon S3 Glacier、Google Cloud、Microsoft Azure BLOBストレージのアーカイブアクセス層など)を接続して階層化することができ、これをCloud Storage Poolとして扱うこともできます。
Poolという単位で格納先を作っておけば、取り込まれてすぐだったり最終更新日時が浅いオブジェクトはオールフラッシュで構成したStorageGRID内の領域に、半年以上経過したオブジェクトはAmazon S3 Glacierに、というようなILMポリシーを使うことで、容量を効率的に使えます。 - どのように?
StorageGRID内に取り込まれたオブジェクトは、デフォルト状態だとレプリケーション(=オブジェクトデータの完全なコピーを作成する)という方法で保護され、レプリカが2つ作成されてそれぞれが別のStorage Nodeに格納されます。
小さめのオブジェクトが中心の環境であればこのままでもよいのですが、GBを超えるような大きなオブジェクトが中心だと、例えば1GBのオブジェクトを格納すると2GB分の容量を消費していくためかなり効率が悪くなってしまいます。
そこで、Erasure Codingと呼ばれる、オブジェクト本体を分割したパーツ(データフラグメント)と追加のパリティ部分(パリティフラグメント)をばらばらにして別のStorage Nodeに格納する保護方法が効果を発揮します。
例えば1GBのオブジェクトをErasure Coding 2+1で格納すると、データ本体が2分割されて2つのデータフラグメントとなり、1つのパリティを追加してそれぞれが別のStorage Nodeに保管されます。
Erasure Coding 2+1を使う場合は1GB分のオブジェクトに対してパリティは50%分のサイズで作られますので、トータルで1.5GB消費したことになり、レプリケーションよりも容量を節約できました。
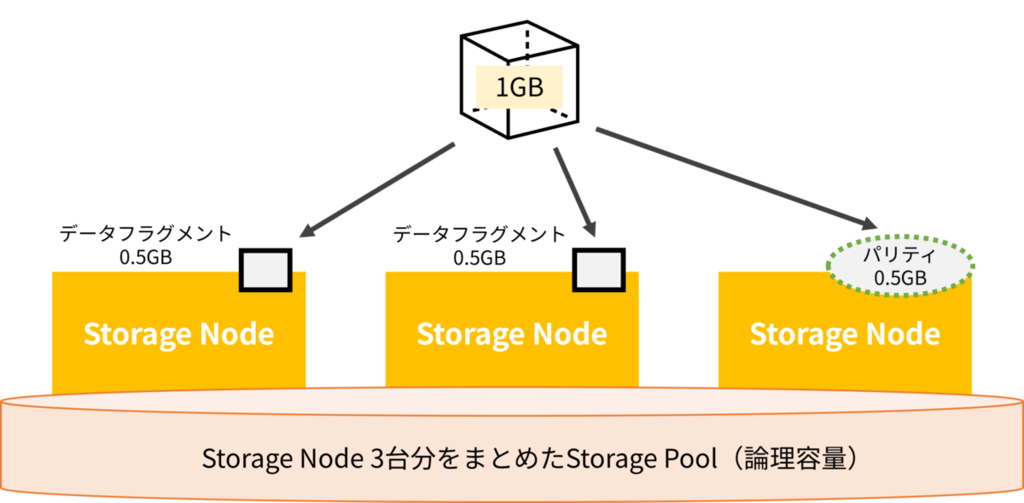
Erasure Codingでデータを何分割するか、パリティをいくつ作るかはStorageGRID内に何台Storage Nodeが構成されているかによって選べるパターンが変わります。
詳しくはこちらをご参照ください。
docs.netapp.com
Erasure Codingは容量効率が良いだけでなく、パリティの数が多ければそれだけ障害に強いというメリットもあります。
反対に、取り込み時には分割とパリティ生成、読み出しをするときにはフラグメントを再度集める動きが発生するため、大量のワークロードがある場合はシステム負荷やレイテンシが高まりやすいという面もあります。
また、Erasure Coding使用にはサイズの制限があり、200KB未満のオブジェクトには適用できず、1MB以上のオブジェクトへの適用が推奨されています。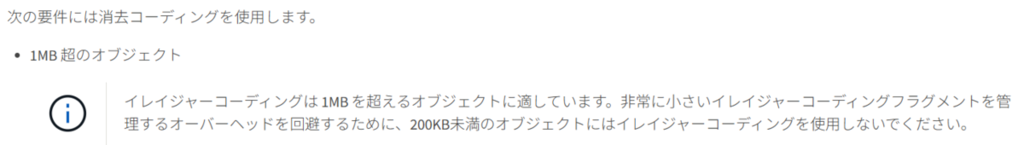
Erasure Codingを利用する場合は、オブジェクトのサイズでフィルタリングしてレプリケーション < 1MB ≦ Erasure Coding となるように運用するのが一般的です。
ワークロードの傾向に合わせて保護方法を選んでみてください!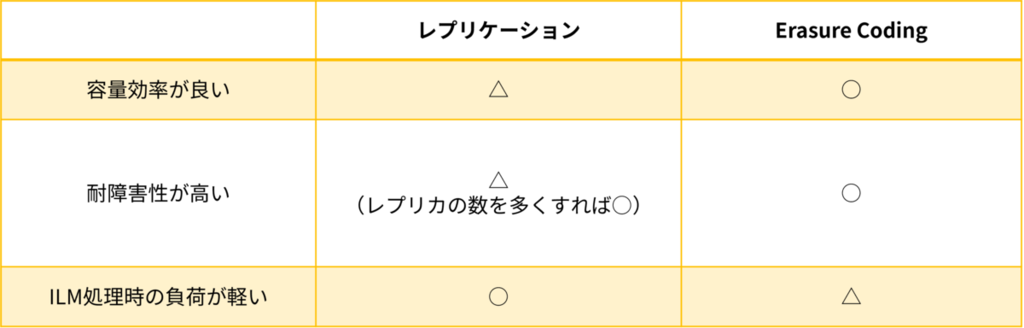
- いつまで?
1のどこに?でご紹介したようなさらに安価なクラウドに移動させるまでの期間を設定する使い方もできますが、データライフサイクルで重要な項目と言えば古くなったデータ、要らなくなったデータの削除ですよね。
ILMの期限設定を利用すれば、取り込まれてからの時間が設定した期間を過ぎたら自動で削除されるような設定も可能です。
以上3つのILM要素をご紹介してきました。
ここでILM活用の一例をイメージ図でお見せします。
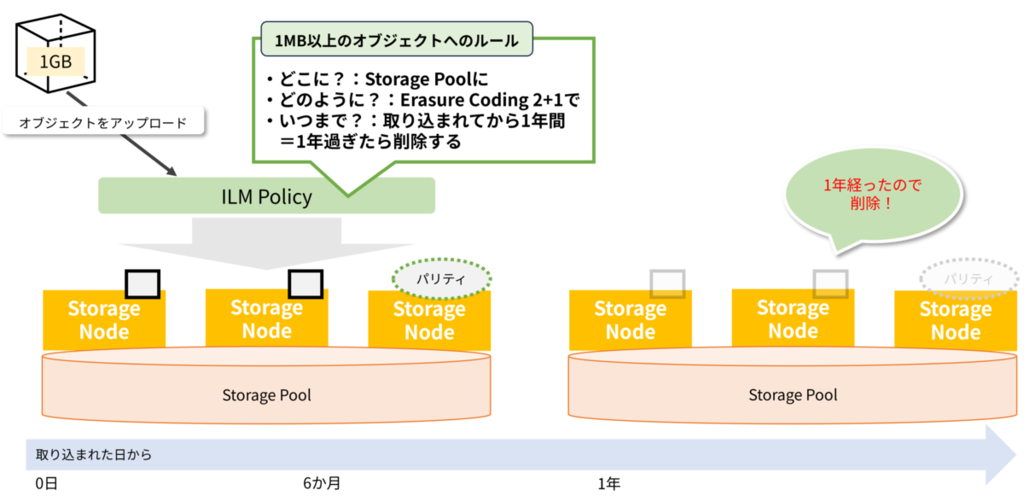
1MB以上のオブジェクトに適用するルールとして、取り込まれたらErasure Coding 2+1で保管して、1年経ったら削除する設定をしています。
1GBのオブジェクトがアップロードされたのでこのルールが適用され、管理者の手間なしにErasure Codingでの保管と1年後の削除をしてくれるシステムが完成しました。
このほかにも拡張子によって保管場所を変えたり、バージョニング機能と併用して最新版ではなくなったオブジェクトを自動で削除していくなど、紹介しきれなかった多種多様なILM活用方法があります。いつか機会があればご紹介したいと思います。
次回予告
次回は検証用としても使いやすいVMware版StorageGRIDを構築していきます!
更新までお待ちください。
▼▼▼▼▼▼▼▼▼▼▼▼▼▼▼▼▼▼▼▼▼▼
ネットワールドが開催する 年に一度の大イベント
【 Networld Wiz 2026 】お申込み受付中!!
本ブログでご紹介したメーカーもイベントへ出展します!
セッション & ブース出展情報 随時更新中
▼ぜひチェックしてください▼